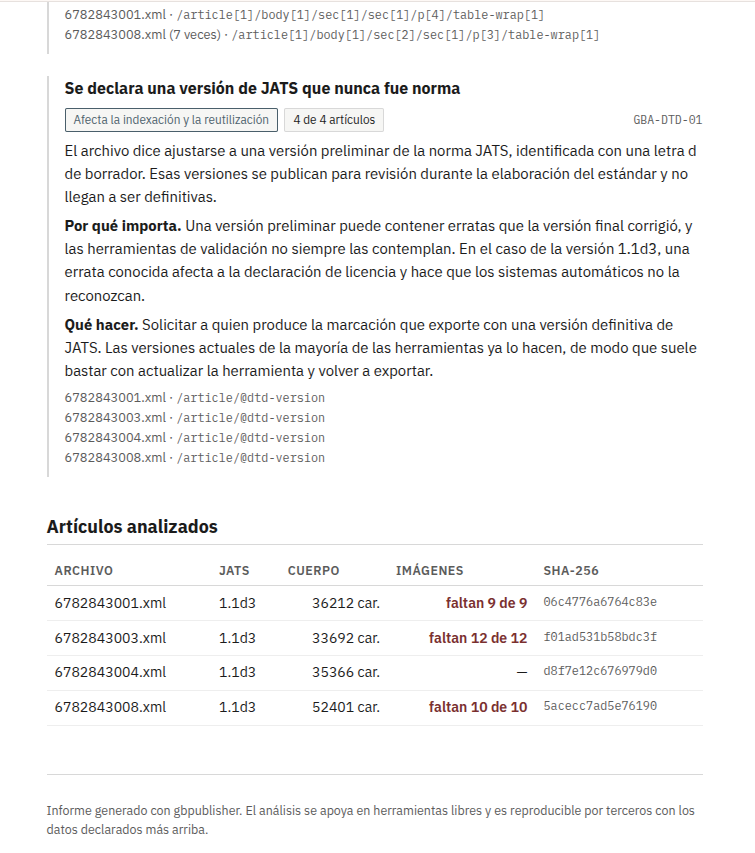

Hay una escena que se repite. Una revista produce su XML, lo deposita, lo cosecha quien tenga que cosecharlo, y todo parece funcionar. Nadie se queja. Los artículos aparecen en las bases. El proveedor de marcación entrega a tiempo. Y sin embargo algo no termina de andar: las citas no se acumulan como deberían, la producción no se atribuye bien a la universidad, alguien reporta que en un dispositivo el artículo se ve raro.
El XML es el único lugar de la cadena editorial que casi nadie mira. El PDF se revisa página por página. La versión web se prueba. Las pruebas de galera se leen tres veces. El XML se genera, se sube y se olvida, porque es un archivo lleno de etiquetas que no está pensado para que lo lea una persona. Este texto es sobre qué aparece cuando alguien lo mira.
Validar no es auditar
Lo primero que hay que separar son tres preguntas que suelen confundirse bajo la palabra “validar”.
¿Es un archivo XML bien formado? Es la pregunta más básica: ¿tiene todas sus etiquetas abiertas y cerradas en orden? Es binaria y no admite opinión. Un archivo que falla acá no lo abre ningún programa del mundo.
¿Cumple la gramática que él mismo declara? Todo XML de un artículo dice, en su primera línea, a qué versión del estándar JATS se ajusta. La validación comprueba que efectivamente la cumpla. También es binaria, pero con una trampa: depende de cuál gramática. Validar un archivo contra una versión distinta de la que declara produce cientos de errores que no son errores del documento.
¿Sirve para lo que quiero usarlo? Esta es la pregunta de la auditoría, y no es binaria. Un archivo puede ser impecable en las dos primeras y aun así ser inútil.
Casi todo lo que voy a contar acá vive en la tercera pregunta.
Por qué “me da error” casi nunca significa lo que parece
Antes de llegar a los hallazgos hay que despejar un ruido que confunde a mucha gente.
Cuando un editor prueba una herramienta de validación en línea y le dice que su archivo tiene errores, en una proporción alta de los casos el problema no está en el archivo. Está en que la herramienta no encontró la gramática contra la cual comparar.
Los archivos JATS declaran su gramática con una dirección de internet. Cuando un programa la necesita, sale a buscarla. Si no hay conexión, si el servidor no responde, si la dirección cambió, o si la herramienta busca una versión distinta de la declarada, el resultado es un error que dice “no pude validar” pero que se lee como “su archivo está mal”.
Medimos esto. Un artículo de 70 KB que un programa tarda medio segundo en analizar cuando la gramática está disponible localmente, tarda ocho segundos cuando tiene que salir a buscarla. De esos ocho, siete y medio son espera. Y si no hay red, falla.
Es una fuente enorme de falsos diagnósticos. Antes de creerle a cualquier validación, vale la pena preguntar contra qué gramática validó y de dónde la sacó.
El corpus
Para poner a prueba el auditor reuní veintiún artículos publicados, de revistas de América Latina, Europa del Este y Asia. No los elegí por problemáticos: los elegí por variados. Salieron de seis herramientas de marcación distintas, que es lo que importa, porque un defecto que aparece en una herramienta es una particularidad y uno que aparece en seis es una característica del ecosistema.
Todos estaban publicados. Todos habían pasado por su proceso editorial. Ninguno era un borrador.
Esto es lo que apareció.
Cinco de veintiún archivos no contienen el artículo
Empiezo por el hallazgo que más me sorprendió, porque es el más grave y el que ninguna herramienta de validación del mercado reporta.
Cinco archivos del corpus tenían metadatos completos, estructura correcta, y el espacio destinado al cuerpo del artículo vacío. En cuatro de ellos, literalmente vacío: cero palabras. El quinto contenía una sola oración en inglés que decía que el contenido estaba en el PDF.
Uno de esos casos es particularmente ilustrativo. El archivo tenía metadatos excelentes —mejores que el promedio del corpus—: nombres de autores en dos alfabetos, biografías, países codificados según norma internacional, doscientas veintisiete referencias bibliográficas completas. Y el artículo no estaba. Había un enlace, correctamente marcado, que apuntaba a la página web donde sí estaba el texto.
Es honesto, dentro de lo que cabe. Pero el resultado práctico es que ese XML no cumple ninguna de las funciones para las que existe. No hay texto completo que cosechar, no hay búsqueda dentro del artículo, no hay conversión a otros formatos, no hay preservación del contenido. El archivo cumple el requisito administrativo de existir.
Esto pasa cuando el XML se genera solo a partir de los metadatos del sistema editorial, y el texto queda únicamente en el PDF. La herramienta hace lo que puede con lo que tiene. El problema está más arriba, en el proceso.
Y es invisible para cualquier validador, porque el archivo es formalmente correcto. Formalmente correcto y semánticamente hueco.
Un archivo que no abre por cuatro caracteres
Otro caso, de otra revista y otra herramienta.
La primera línea del archivo declaraba una codificación de caracteres distinta de la que el archivo efectivamente usaba. Es el equivalente a una etiqueta que describe un contenido que no es el que hay adentro.
Ningún programa que respete el estándar puede abrir ese archivo. No lo abren los indexadores, ni los sistemas de depósito de identificadores, ni los cosechadores de metadatos. El artículo, a efectos prácticos, es invisible.
El arreglo son cuatro caracteres en la primera línea.
Este caso me hizo cambiar el diseño del auditor, y creo que la lección es general. Si uno clasifica los problemas por el esfuerzo que cuesta corregirlos —que es lo primero que quiere saber un editor— este defecto queda en la categoría más trivial, junto a los espacios sobrantes. Y es el más grave de todos.
Por eso el informe usa dos ejes independientes: cuánto daño hace y cuánto cuesta arreglarlo. No son la misma cosa y confundirlos lleva a priorizar mal.
Tres licencias distintas en el mismo documento
En un archivo del corpus, la licencia del artículo estaba declarada tres veces y las tres decían cosas diferentes.
El campo que leen los programas apuntaba a una licencia que permite el uso comercial. El texto visible que leen las personas mencionaba una licencia que lo prohíbe. Y una nota al pie, ubicada además en el lugar equivocado —el destinado a declarar conflictos de interés—, decía que la venta con fines de lucro estaba prohibida.
Las máquinas leen el atributo. Los lectores leen el texto. Si una parte permite algo que la otra prohíbe, cada quien actúa según lo que leyó, y la discrepancia recae sobre la revista.
Ningún validador de gramática detecta esto, porque las tres declaraciones son formalmente correctas por separado. Solo aparece cuando alguien compara un dato del archivo contra otro dato del mismo archivo.
Los nombres al revés
En otro artículo, el apellido y el nombre de pila del primer autor estaban en campos intercambiados. Lo detecté comparándolos con su dirección de correo, donde el nombre precedía al apellido, al revés de lo que decía el XML.
Si la inversión es real —y en ese caso lo parecía—, todas las citas automáticas del artículo atribuyen la autoría al revés, de forma permanente. Además se rompe la vinculación con los sistemas de identificación de autores, con lo cual el trabajo no se acumula en el perfil de quien lo escribió.
Este hallazgo el auditor lo reporta como posible, no como cierto, y esa distinción me parece central. Una herramienta que afirma más de lo que sabe pierde autoridad en la primera equivocación. Distinguir lo que se sabe de lo que se sospecha es parte de lo que hace creíble un dictamen.
Dieciocho de ochocientas una
Las revistas que registran identificadores de objeto digital para sus artículos —los DOI— pagan por ese servicio. Una de las funciones que reciben a cambio es la vinculación de citas: cuando un artículo cita a otro, ambos quedan conectados, y la revista citada recibe el crédito correspondiente.
Para que eso funcione, el DOI de cada obra citada tiene que estar en el campo destinado a identificadores. En el corpus, de ochocientas una referencias bibliográficas, dieciocho lo tenían ahí.
No es que las demás no tuvieran DOI. Muchas lo tenían, pero escrito dentro de un comentario o de un enlace de texto, donde una persona lo lee perfectamente y un programa no lo encuentra.
Es una función paga que la mayoría de las revistas del corpus no está recibiendo, por un dato que ya está en el archivo pero en el lugar equivocado.
Ninguna afiliación identificada
Sesenta y cuatro afiliaciones institucionales en veintiún artículos. Ninguna llevaba identificador normalizado de institución.
Ninguna de las seis herramientas de marcación lo emite.
El nombre de una universidad se escribe de muchas maneras: con o sin “Universidad Nacional de”, con la sigla, con el nombre de la facultad adelante, en el idioma local o en inglés. Basta una variación para que un sistema no reconozca que se trata de la misma institución.
Sin identificador, la producción de una revista no se atribuye automáticamente a las instituciones de sus autores. Y eso es exactamente lo que las universidades necesitan para sus informes de gestión y sus evaluaciones.
Es un caso donde el auditor cambia de tono. Cuando un defecto aparece en todas las herramientas conocidas, señalarlo como falla de una revista en particular sería injusto, y le daría al proveedor el argumento fácil de que nadie lo hace. Tiene razón: nadie lo hace. El informe lo presenta entonces como lo que es —un espacio vacío del ecosistema— y no como un reproche.
Las figuras que nadie puede ver
Aparecieron dos formas opuestas de fallar en lo mismo.
Unas herramientas no emiten descripción alternativa para las imágenes. Otras la emiten siempre, y su contenido es una copia del epígrafe que ya aparece debajo de la figura.
El resultado es el mismo. Quien usa un lector de pantalla escucha dos veces el mismo texto y no recibe ninguna información sobre lo que la imagen muestra. La segunda forma es peor en un sentido: como el elemento está presente, las revisiones automáticas de accesibilidad dan el punto por cumplido.
En veintiún artículos no encontré una sola figura con descripción real.
Y aparecieron ocho tablas compuestas como imagen. Los datos están visualmente y no existen como datos: no se pueden copiar, ni buscar, ni leer con un lector de pantalla, ni reutilizar. Tampoco se adaptan al ancho de pantalla, así que en un teléfono resultan ilegibles.
Para las publicaciones que circulan en la Unión Europea, la accesibilidad de los contenidos electrónicos dejó de ser una buena práctica para convertirse en una exigencia normativa. Es un dato que conviene tener presente antes de que llegue como reclamo.
Lo que se descubre mirando varios artículos a la vez
Este es, para mí, el hallazgo metodológico de todo el proceso.
Un solo artículo no permite distinguir un defecto del procedimiento de producción de un descuido en un artículo puntual. Y son dos conversaciones completamente distintas, con destinatarios distintos.
Lo vi con claridad en el primer lote. Analicé cuatro artículos de una misma revista. Casi todos los problemas aparecían en los cuatro: eran de la herramienta. Pero uno aparecía en uno solo, y era justamente el que yo había marcado como más grave al mirar ese artículo aislado: el título traducido al inglés estaba declarado como si estuviera en español.
Si hubiera auditado un solo artículo, habría acusado a la herramienta de algo que hizo una persona una vez.
Por eso el auditor trabaja por lote y por revista, y cada hallazgo lleva su frecuencia: en cuántos artículos de esa revista aparece. Cuatro de cuatro se le lleva al proveedor de marcación. Uno de cuatro se le lleva al editor. Ese número, que parece un detalle, es lo que hace justo el informe.
Con menos de tres artículos la frecuencia no distingue nada, y el informe lo declara explícitamente en lugar de dar un número que no significa lo que parece.
Un hallazgo que nadie espera: la herramienta ya se arregló sola
Comparé dos versiones de una misma herramienta de marcación, presentes ambas en el corpus.
De los ocho defectos sistemáticos que encontré en los archivos producidos con la versión antigua, cinco ya están resueltos en la versión que ese mismo proveedor distribuye hoy. El identificador mal formado, la ausencia de datos de localización, las tablas convertidas en imagen, y dos cosas más.
Eso cambia por completo la conversación con esa revista. No es “su XML está mal”. Es: “su marcación se hizo con una versión de hace diez años; la versión actual de la misma herramienta ya corrige cinco de estos ocho puntos; antes de corregir artículo por artículo, evalúen reexportar la colección”.
Es concreto, verificable, no acusa a nadie y les ahorra dinero.
Desde entonces el auditor detecta la herramienta y su versión, y cuando existe una versión más nueva lo dice en el informe.
Qué mide un informe honesto
Todo esto solo sirve si el informe se sostiene cuando alguien lo discute. Y alguien lo va a discutir: el editor se lo va a pasar a su proveedor de marcación, y el proveedor va a contestar que a él le valida bien.
Por eso cada informe lleva, arriba de todo:
- la huella criptográfica de cada archivo analizado, para que no haya dudas sobre cuál se auditó
- la versión exacta de cada herramienta usada
- la gramática contra la que se comparó
- el perfil de reglas aplicado
- y una lista explícita de lo que no se evaluó
Ese último punto es el que más me costó aceptar y el que más valor tiene. Un informe que declara sus límites es creíble. Uno que no los declara parece diseñado para vender algo.
Y empieza por lo que está bien. No por cortesía: porque es información. Una revista con identificadores de autor completos en todos sus artículos y permisos correctamente declarados es una revista que hizo cosas bien y que puede hacer el resto. Un informe que es todo rojo se lee como un truco.
Las reglas no son mías
Una parte de lo que el auditor revisa proviene de recomendaciones publicadas por un grupo de trabajo internacional dedicado justamente a la reutilización de artículos marcados en JATS. No son criterios propios.
La distinción importa más de lo que parece. “No cumple una recomendación internacional” y “no cumple una regla de mi programa” son dos afirmaciones muy distintas cuando el proveedor contesta. La primera se verifica contra un documento público; la segunda es una opinión.
Ahora bien, adoptar esas reglas no fue tan simple como parecía, y vale la pena decirlo porque contradice la impresión de solidez que da un estándar.
La versión compilada que el proyecto distribuye tiene un error que impide ejecutarla. Al compilarla por mi cuenta con dos herramientas distintas obtuve dos fallas diferentes, cada una perdiendo una parte del código. Y hay reglas que directamente se caen con estructuras normales: una de ellas aborta con cualquier artículo que tenga subsecciones, que es la mitad de los artículos académicos que existen.
La conclusión no es que las reglas sean malas —son buenas, y la especificación es correcta—, sino que no hay nadie verificando que se ejecuten sobre material real. Terminé usando un subconjunto verificado artículo por artículo contra mi propio corpus, aislado de modo que si una regla falla se pierde ese grupo y no el análisis entero.
Es una lección que vale para todo el ecosistema editorial: que algo esté publicado como estándar no significa que funcione tal como se distribuye.
Dónde está el valor cotidiano
Hasta acá esto puede leerse como un diagnóstico de problemas ajenos. Pero el valor real no está en auditar lo que otros produjeron: está en incorporar la auditoría a la producción propia.
Porque los defectos son sistemáticos. Casi todo lo que encontré aparecía en todos los artículos de cada revista. Eso significa que se corrigen una vez, en el procedimiento, y no artículo por artículo. Un lote de cuatro artículos alcanza para detectar lo que va a repetirse en los próximos cuarenta.
Porque el costo de detectarlo tarde es alto. Un DOI de referencia mal ubicado no se nota nunca. Simplemente la revista no aparece donde debería aparecer, y nadie sabe por qué. Un nombre invertido se propaga a todas las citas futuras del artículo. Una tabla convertida en imagen no se recupera: los datos ya no están.
Porque cambia la relación con el proveedor. Un editor que puede decir “en estos cuatro artículos aparece este punto, en la ubicación exacta que le indico, y su herramienta en versión actual ya lo corrige” está en otra posición que uno que dice “creo que algo anda mal”.
Porque el XML es lo que sobrevive. El PDF es una fotografía del artículo tal como se veía hoy. El XML es el artículo en una forma que se puede volver a componer dentro de veinte años, con la tecnología que exista entonces. Si está incompleto, lo que se pierde no se recupera.
Lo que esto no hace
Conviene ser claro también con los límites.
Una auditoría de marcación no evalúa la calidad del contenido. No dice si un artículo es bueno, si la revisión por pares fue rigurosa o si las referencias son pertinentes. Mira la forma, no el fondo.
No reemplaza el criterio editorial. Varios de los hallazgos requieren que una persona decida: cuál de las tres licencias es la correcta, si el nombre está efectivamente invertido, si un cuerpo breve es una conversión incompleta o una reseña legítimamente corta.
Y no todo lo que señala hay que corregirlo. Un informe con veinte hallazgos no es una lista de tareas obligatorias: es un mapa. Algunos puntos se corrigen en cinco minutos para toda la colección; otros requieren rehacer el procedimiento de producción y valen la pena solo de aquí en adelante.
Una última cosa
Lo que más me quedó de este proceso no es ninguno de los hallazgos individuales, sino algo más incómodo.
Los veintiún archivos estaban publicados. Habían pasado por su proceso editorial completo. Sus revistas están indexadas. Y en ninguno de los casos —ni uno— alguien había mirado el XML.
No por descuido. Porque no hay una práctica establecida de mirarlo, ni herramientas pensadas para que lo mire quien toma las decisiones editoriales, ni un vocabulario para hablar de esto que no sea el de los programadores.
El XML no es un requisito administrativo. Es la forma en que el artículo va a existir cuando el sitio de la revista cambie de plataforma, cuando el PDF se vuelva ilegible, cuando alguien quiera leerlo con una tecnología que todavía no existe. Merece la misma atención que las pruebas de galera.
Mirarlo lleva unos minutos. No mirarlo cuesta bastante más.
El auditor descrito en este artículo es parte de gbpublisher, un sistema de producción editorial académica de código abierto. Está construido sobre herramientas libres y los informes que emite son reproducibles por terceros con los datos que declaran. Si una revista quiere revisar sus propios archivos, se puede hacer.
Figura 1
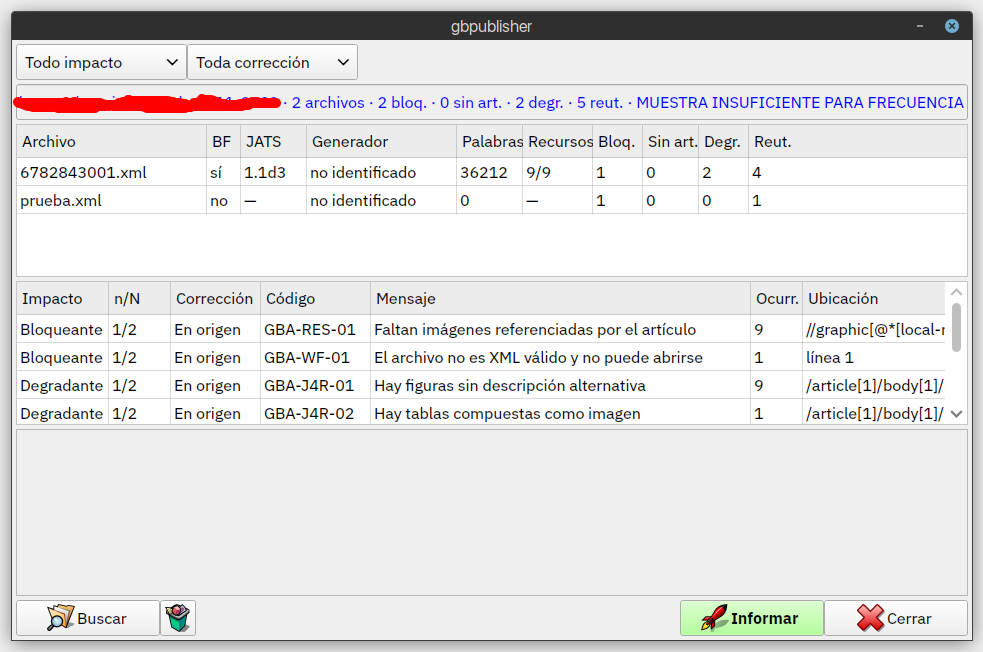
Figura 2
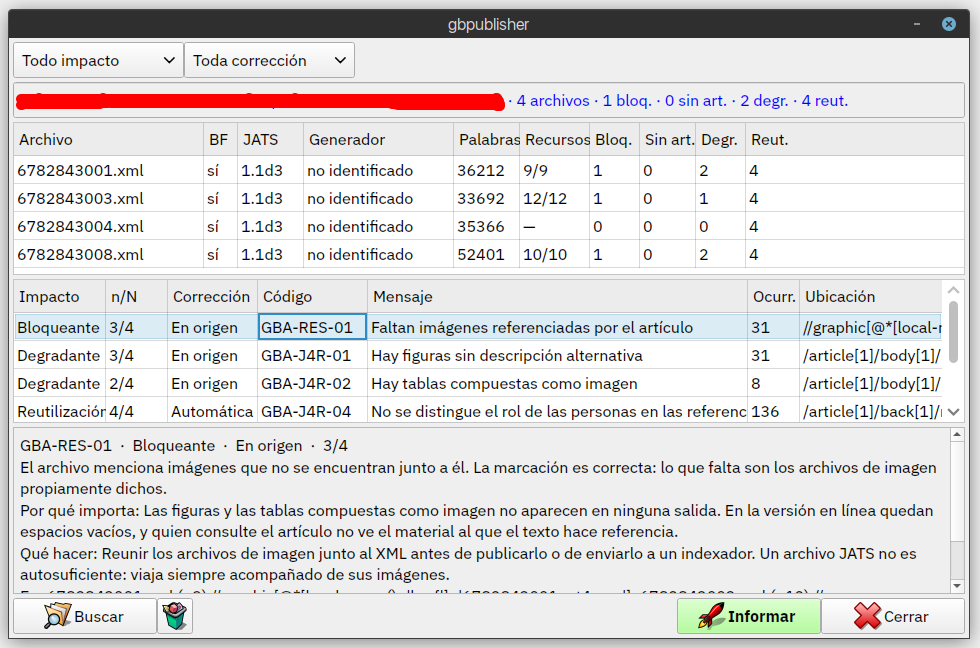
Figura 3
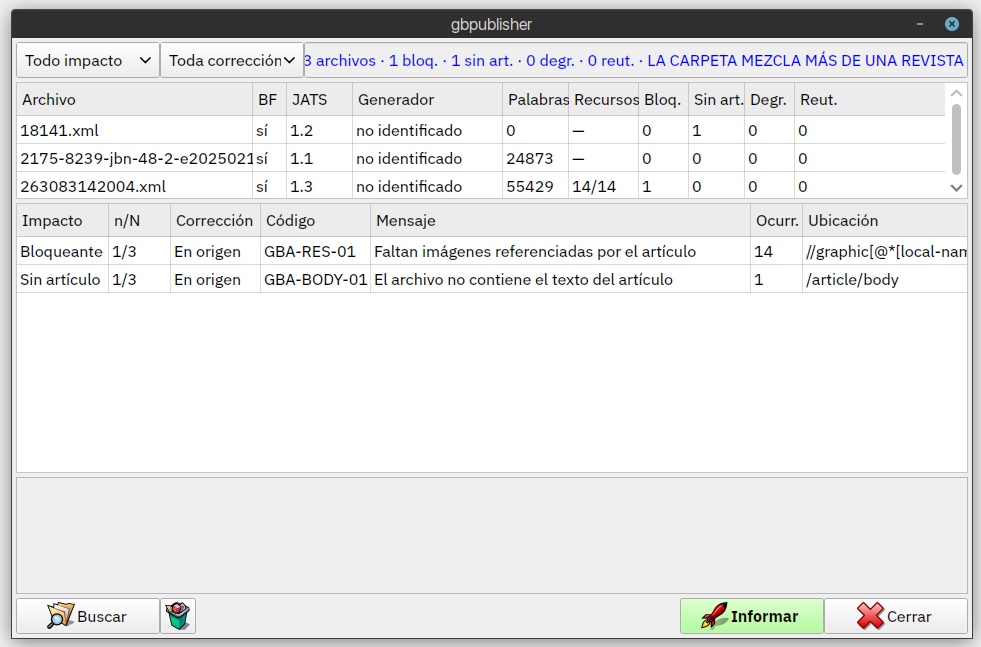
Figura 4
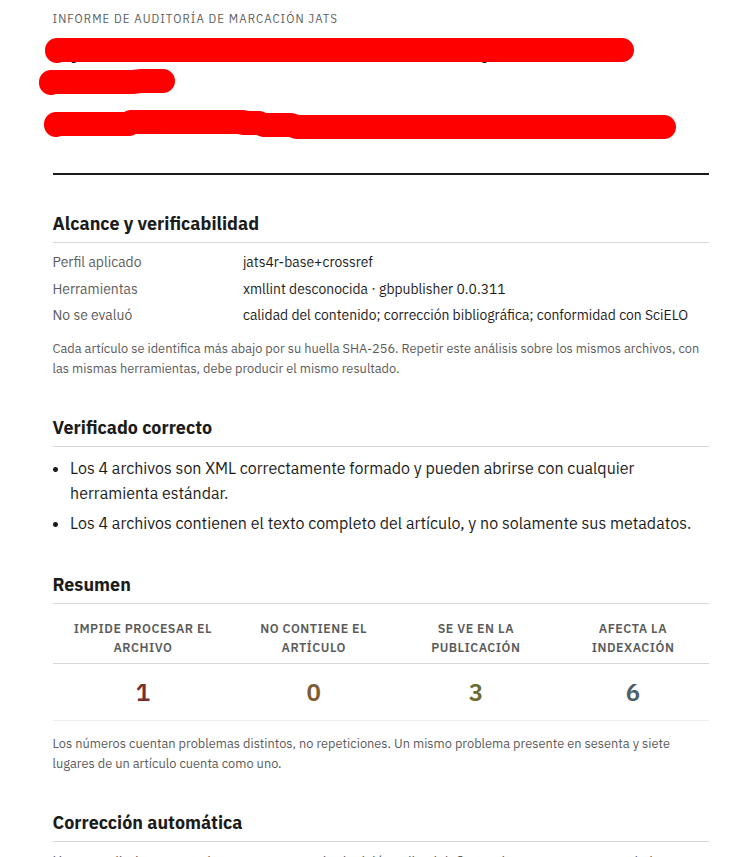
Figura 5
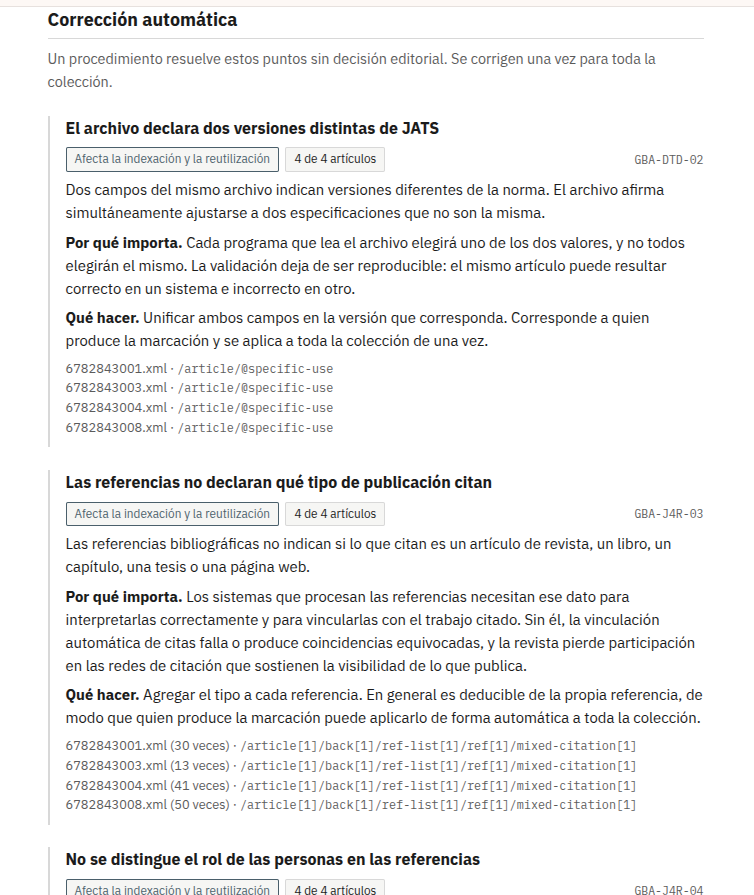
Figura 6
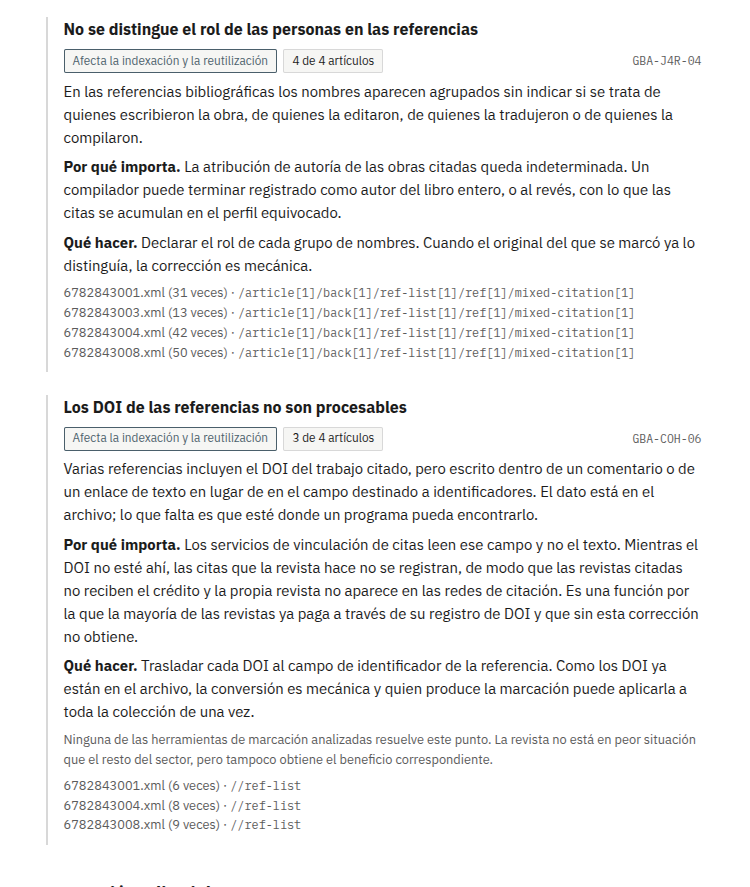
Figura 7
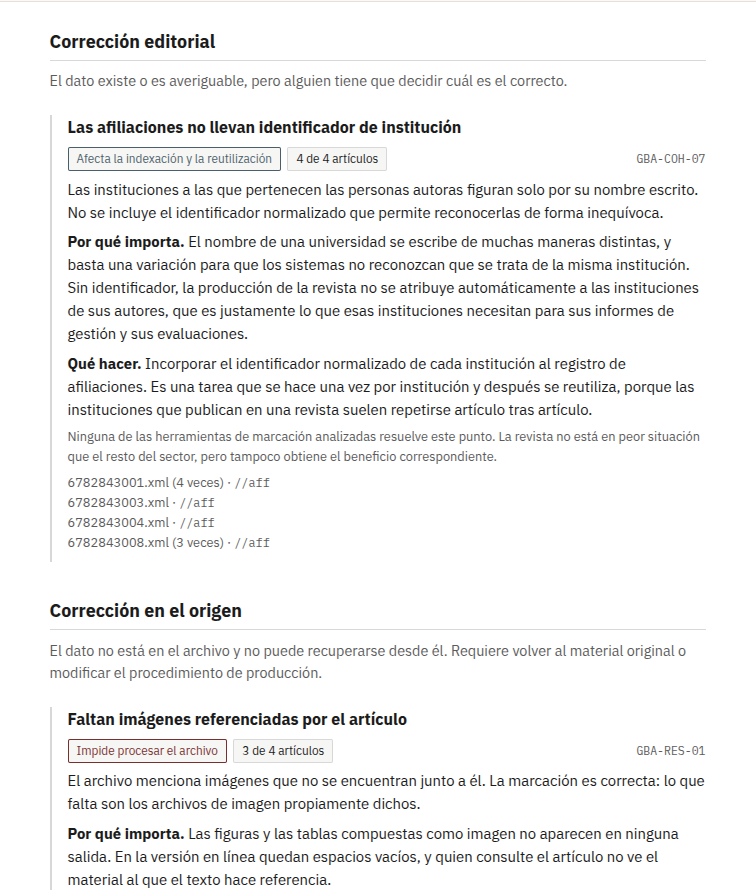
Figura 8
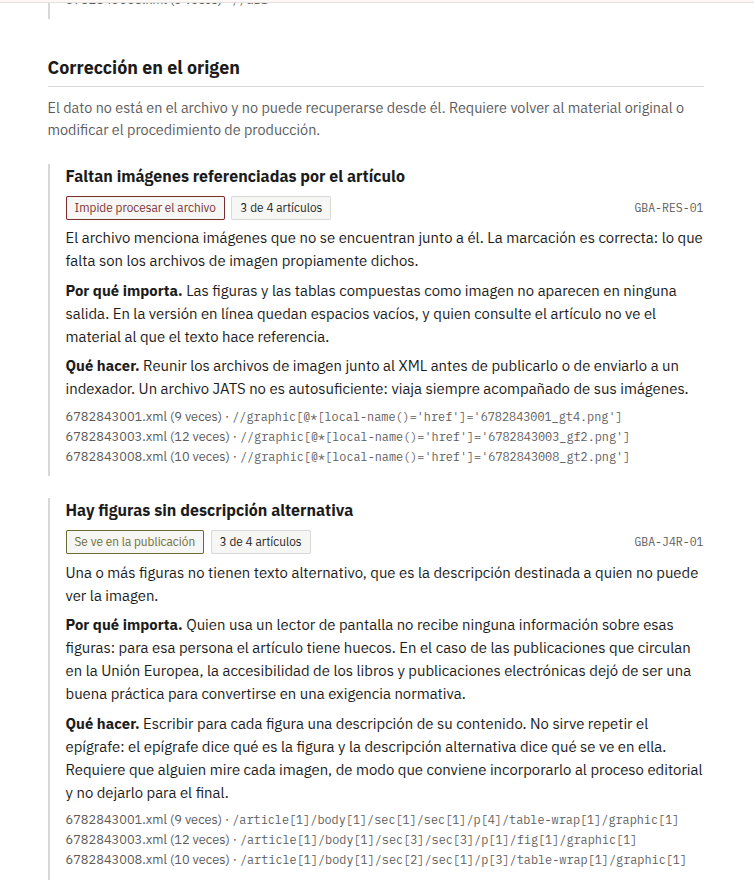
Figura 9
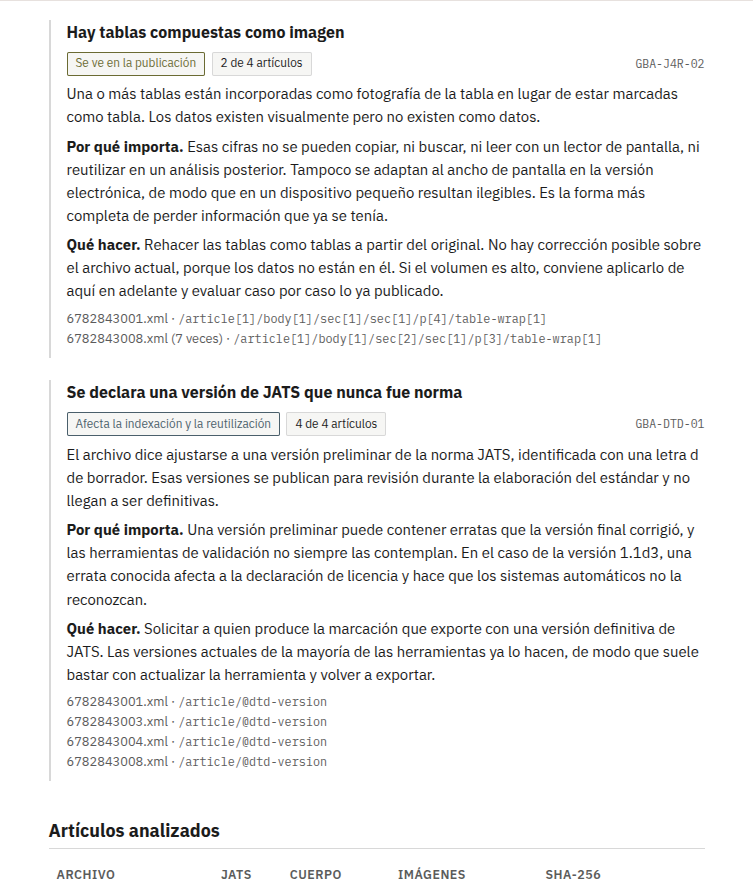
Figura 10